Immich 人脸识别怎么用:自动分组、命名与手动修正
人脸识别是 Immich 从「存照片的」变成「懂照片的」的那一步。机器自动把几十万张脸聚成一团团,你只负责给每团起名字——之后按人浏览、按人搜索都水到渠成。
工作原理:先检测,再聚类
两阶段流水线:
- 检测:机器学习容器逐张扫描照片,框出所有的人脸;
- 聚类:把长得像的脸归成同一组(同一「人物」),同时为每张脸生成单独的小缩略图。
理解「聚类」这个词很关键:机器不知道谁是谁,它只知道哪些脸像。所以初次处理完,你看到的是「人物 1、人物 2……」一堆未命名分组,等着你命名。
日常操作:命名与浏览
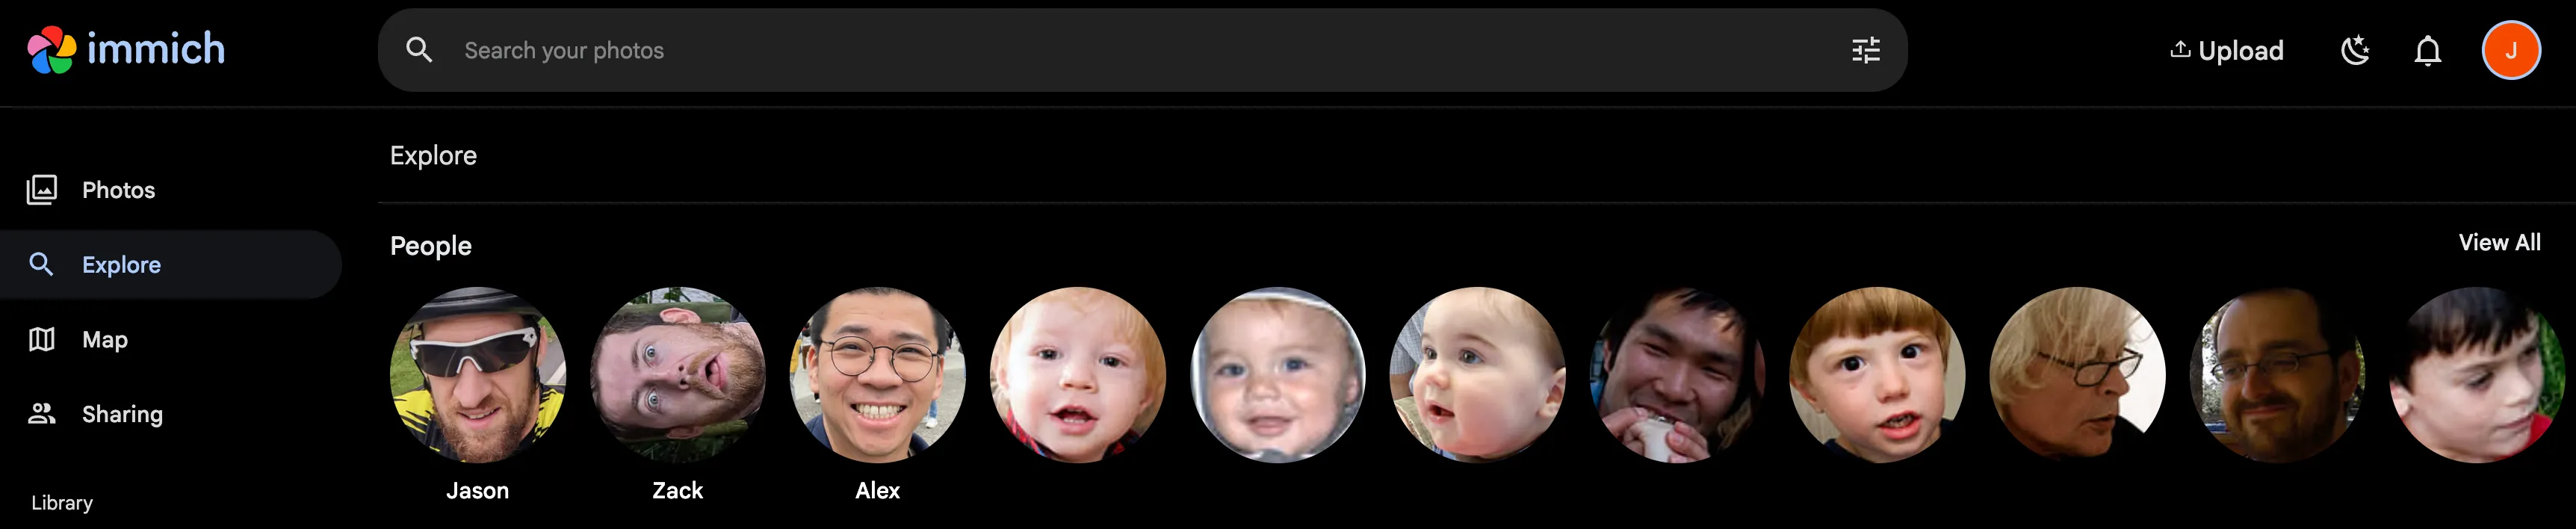
入口在网页端/手机端的人物(People)页。点开一个未命名的人物分组,输入名字(可加生日)保存即可。命名后:
- 人物页变成带名字和头像的相册墙;
- 高级筛选 里可以直接按人物筛;
- 点开某个人物,看到这个人出镜的所有照片,可以设置「收藏人物」置顶。
修正:机器错漏怎么手动补
聚类不是百分百准,官方给了两把修正工具:
- 手动标注:打开任何一张照片,在人脸区域点选即可把它标给某个已命名人物,或新建人物——漏检、认错的都能改;
- 移除错误标注:同样入口,把不属于某人的脸摘出来。
聚类效果不好时调参数
管理后台 Machine Learning Settings → Facial Recognition 有两个核心旋钮:
- 最小检测分数/人脸数:控制「多像才算同一人」的门槛,调小 → 合并更激进(组变少),调大 → 分组更保守(组变多);
- 改完参数需要对全库重跑人脸识别任务(任务队列 触发)。
社区还有一篇官方指南专门讲「如何获得更好的人脸聚类」,核心思路就一句:先手动把明显错分的脸修正一批,再重跑聚类,机器会跟着你的修正收敛。参数随版本可能调整,以官方文档为准。
进阶:跨用户的人脸共享(v3.2 起)
同一台服务器上,机器只见过各自用户库里的脸,所以「你库里孩子的脸」和「伴侣库里孩子的脸」默认是两个不相干的人物。v3.2.0 的 cluster group(聚类分组) 开始打通这层:互信的用户加入同一分组后,机器学习可以在合并后的更大脸池上聚类,你能在彼此共享的照片里看到自己已命名的人物。首次启用需要对分组内所有用户重置人脸识别(名字会丢,需重新命名),官方也在持续改进这个方向——细节以当前版本文档为准。
内存与关闭
人脸识别和 语义搜索 一样吃机器学习资源。低配机器可以在设置里单独关掉人脸识别、保留语义搜索(或反过来);两者全关的后果见 硬件要求。